2026 年 11 月 12 日,Blank Bio 发布 RNA 基础模型 Ladon。这款模型拥有 30 亿参数,在数百万份 bulk RNA-seq 样本上训练,面向治疗反应和患者预后预测。团队同时公开了技术报告,展示跨癌种、跨队列及跨测序平台的评估结果。
它要回答的问题很具体:哪些患者更可能对药物产生反应,哪些患者的疾病进展风险更高?Ladon 将大规模 RNA 表征学习接到了患者级临床结局预测上。本次报告的主要结果来自既有患者队列和留出的临床试验数据。
图说 / 两位患者的 Ladon 表征可视化艺术图
让模型读懂一份转录组
可以把基因表达谱理解为一份细胞活动记录,呈现不同基因在样本中的活跃程度。Ladon 从整份转录组中学习分子特征,用于连接肿瘤状态与患者结局。它的主要训练对象是混合细胞样本的整体转录组,即 bulk RNA-seq。
技术上,Ladon 采用 Transformer 编码器—解码器架构。预训练使用异构体层面的序列信息,通过遮蔽 token 再重建的自监督任务学习。随后,团队利用带有结局标签的数据调整表征,再接上生存分析或治疗反应预测模型。
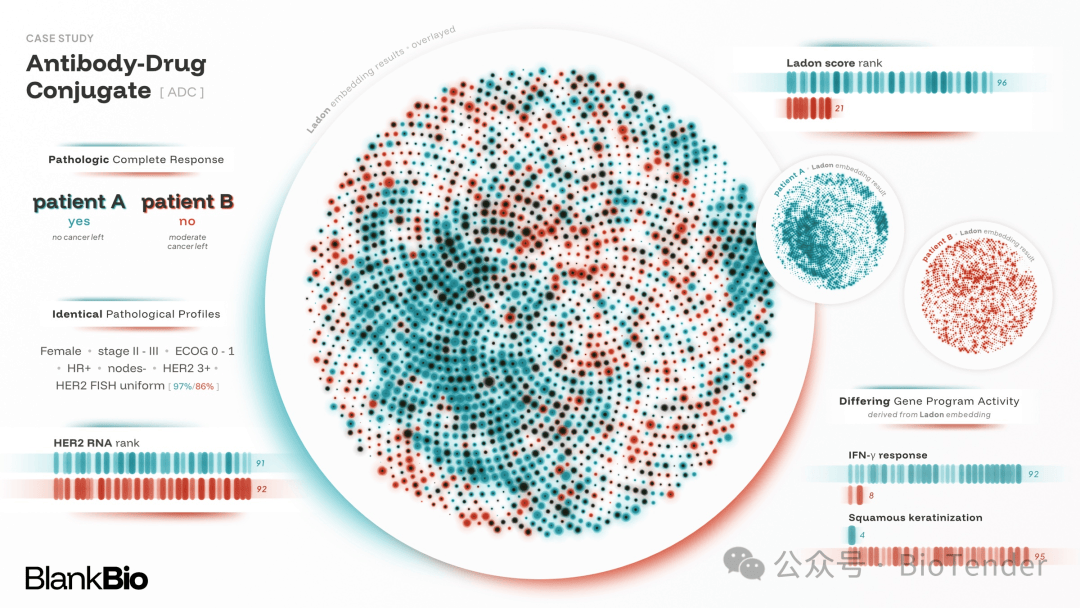
图说 / 官方患者案例:相似病理特征下的不同治疗反应及分子表征
把整项临床试验留作考题
RNA 数据会受到样本处理、建库方式和测序平台影响。团队将跨队列迁移作为重点:在一组患者上拟合预测器,再应用于另一组患者。在 TCGA 与 CPTAC 的双向测试中,Ladon 与临床变量结合后,改善了全部 12 个目标癌种队列的生存排序。
评估进一步延伸到临床试验。报告的生存分析覆盖 8 项试验,包括 6 项总生存期读出和 3 项无进展生存期读出。对每项待评估试验,结局预测器使用其他队列拟合,再对该试验的患者打分,检验预后信号能否迁移。
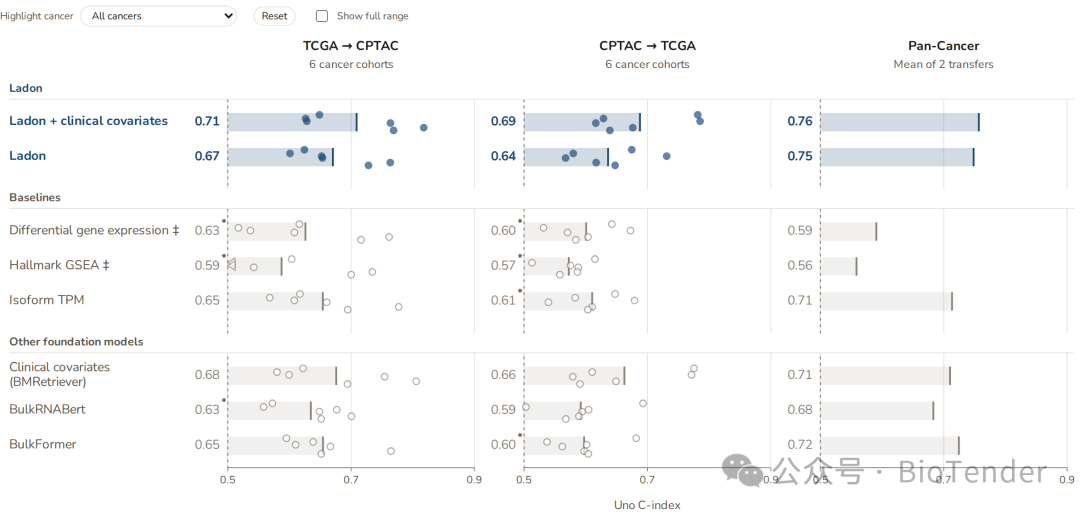
图说 / TCGA 与 CPTAC 之间的跨队列生存预测评估
OAK 肺癌试验提供了一个直观案例。团队将 Ladon 与临床变量结合,对 699 名患者评分,并按预测风险中位数分成两组。高风险组的中位总生存期为 7.9 个月,低风险组为 15.5 个月。这些数字描述的是分组后的实际生存结局。
该预测器在 OAK 中的 Uno C-index 为 0.61,用于衡量患者生存时间的排序能力。这里的 7.9 与 15.5 个月,反映模型识别出的预后差异。模型的工作是划分风险,并未通过干预延长患者生存。
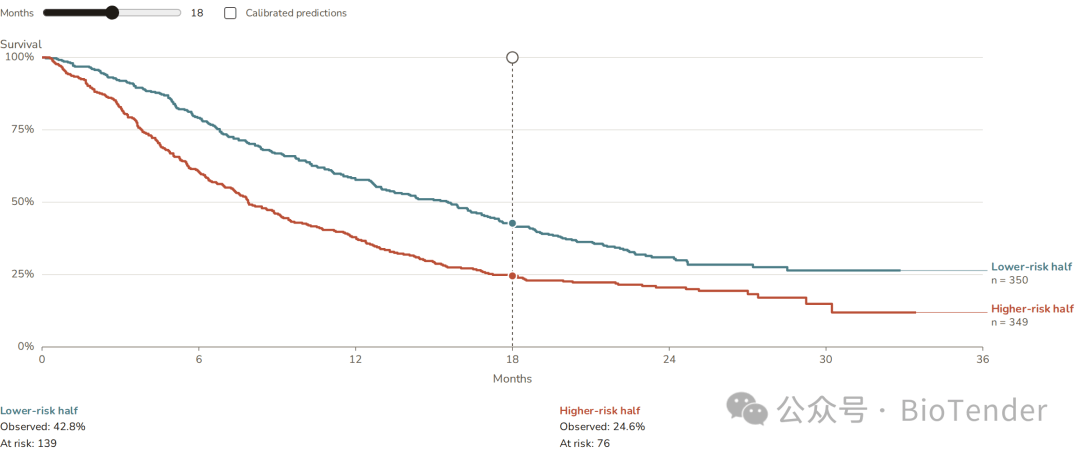
图说 / OAK 队列按预测风险分组后的实际总生存曲线;已关闭校准预测虚线
治疗反应测试覆盖另外一组 6 项留出试验,涉及肺癌、尿路上皮癌、肾癌和肝癌。模型根据治疗前 RNA 数据,区分按 RECIST 标准达到完全或部分缓解的患者。用于预测的标签上下文包括 33 个学术队列中的 1,419 名患者及其他试验,排除当前测试试验。
官方图表显示,Ladon 的六试验平均 AUROC 为 0.673,差异基因表达基线为 0.633,PD-L1 mRNA 基线为 0.597。这里衡量的是对反应者与非反应者的排序区分能力。AUROC 0.673 不等于“67.3% 的患者预测正确”。

图说 / 六项留出临床试验中的治疗反应预测 AUROC 对比,各试验等权平均;PD-L1 对照为 mRNA 表达
从“谁会缓解”走向“谁更受益”
对药物研发来说,还需要回答一个比较问题:同一类患者接受新药,相比接受对照治疗能获得多少额外收益?预后标志物描述疾病走向,预测性标志物描述不同治疗之间的获益差异。这一区分关系到试验应优先纳入哪些患者。
团队选择肺癌随机 II 期试验 POPLAR 进行测试。他们在其他 5 项试验上训练治疗获益预测头,以 12 个月无进展生存为目标,并调整基础预后信号。随后将评分应用于 POPLAR,比较阿替利珠单抗与多西他赛两组中的表现。
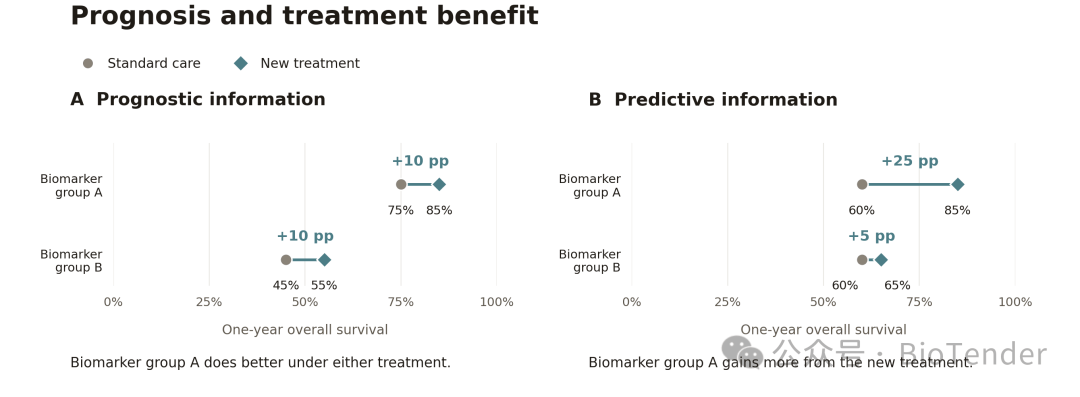
图说 / 预后标志物与治疗获益标志物的概念区别,图中数值为假设性示例
在 POPLAR 的 192 名有分子数据的患者中,团队按全队列评分中位数分组。接受阿替利珠单抗时,高分组与低分组的 12 个月无进展生存率分别为 28% 和 6%;接受多西他赛时,分别为 14% 和 13%。这些比例为报告中的生存估计。
这一分组在免疫治疗组中呈现较大差异,在化疗对照组中则较为接近。团队据此报告,Ladon 评分呈现了与治疗获益相关的分层信号。同一评分在不追加训练的情况下,也区分了免疫治疗组中记录的肿瘤反应。
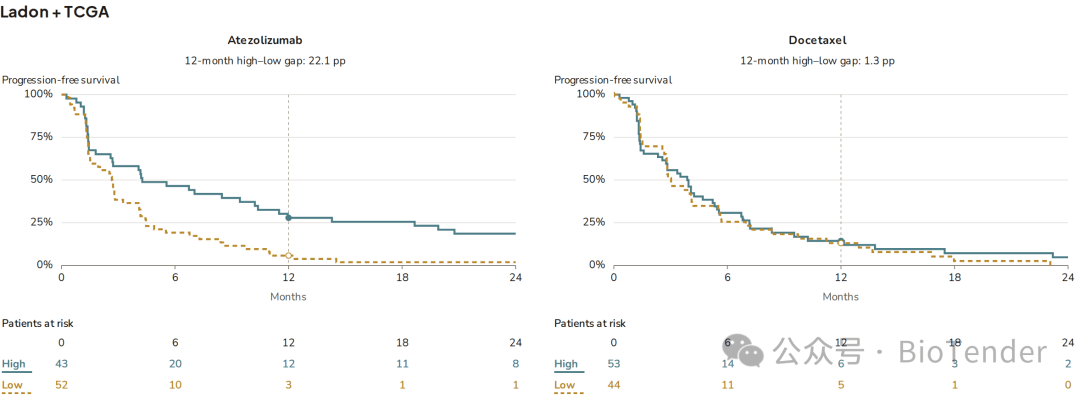
图说 / POPLAR 中高低 Ladon 评分组在两种治疗下的无进展生存曲线;下方为仍处于风险集的人数
从基因总量推断 RNA 的不同版本
一个基因可以通过不同剪接方式,生成多个 RNA 版本,称为异构体。Ladon 的另一项任务,是从基因总表达推断这些版本各自的占比。直观地说,输入给出某类产品的总量,模型进一步推断不同版本的构成。
这一任务对应常见的数据条件:不少单细胞、单核及 3′ 端捕获测序,主要提供基因层面的表达。团队在测试时隐藏异构体丰度,只向模型提供基因表达,再与 bulk RNA-seq 的异构体定量结果比较。单细胞与单核数据在此先按样本汇总。

图说 / 由基因总表达推断不同 RNA 异构体占比的任务示意
在 166 份胃癌样本中,Ladon 对胰岛素受体基因 INSR 的异构体占比预测,与测量结果的 Pearson 相关系数为 0.93。扩大到 8 类留出癌症、随机抽取的 3,000 个多异构体基因后,相关系数中位数为 0.81,队列内训练基线为 0.69。
团队还利用配对的单核与 bulk 数据,评估同一供者不同器官间的异构体变化。在 1,402 次器官配对比较中,Ladon 的变化预测相关系数为 0.80,器官平均值基线为 0.68。这部分测试考察的是从较粗粒度输入恢复异构体信息的能力。

图说 / 留出肿瘤队列中异构体占比预测与多种基线的比较
从一份混合样本中读出细胞组成
肿瘤样本包含癌细胞、免疫细胞和基质细胞等多种成分。Ladon 还用于从 bulk RNA-seq 中推断这些成分的相对占比,即细胞组成反卷积。这相当于从混合录音中辨认不同声部,为患者的分子特征增加可解释的组成信息。
团队将单细胞数据加总为合成混合样本,与真实 bulk 数据共同后训练,使二者进入共享表征空间。下游模型先从合成样本学习组成,再预测真实样本。在 35 份外周血单个核细胞 bulk 样本中,报告显示其表现优于所比较的反卷积方法。
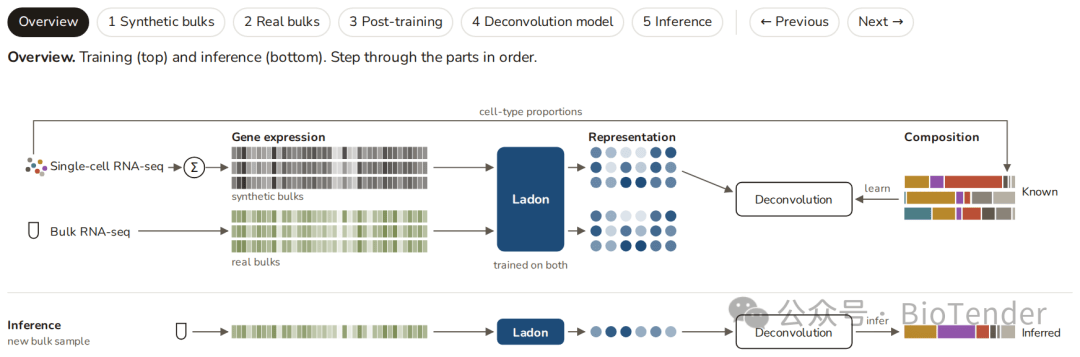
图说 / 将单细胞合成样本与 bulk RNA-seq 映射至共享表征的官方流程
在乳腺癌任务中,团队根据推断的细胞组成,在 TransNEO 队列训练模型,再应用于外部队列。对 ER+/HER2− 患者,ARTEMIS 与 PBCP 子队列的病理完全缓解预测 AUC 分别为 0.90 和 0.97。两组分别有 35 人和 13 人,各有 3 人达到病理完全缓解。
相同两组中,Oncotype DX 基因表达替代评分的 AUC 为 0.75 和 0.77,MammaPrint 替代评分为 0.88 和 0.87。这里比较的是根据 RNA 数据重建的评分;报告中的病理完全缓解,指手术时乳房和淋巴结中无残余浸润癌。
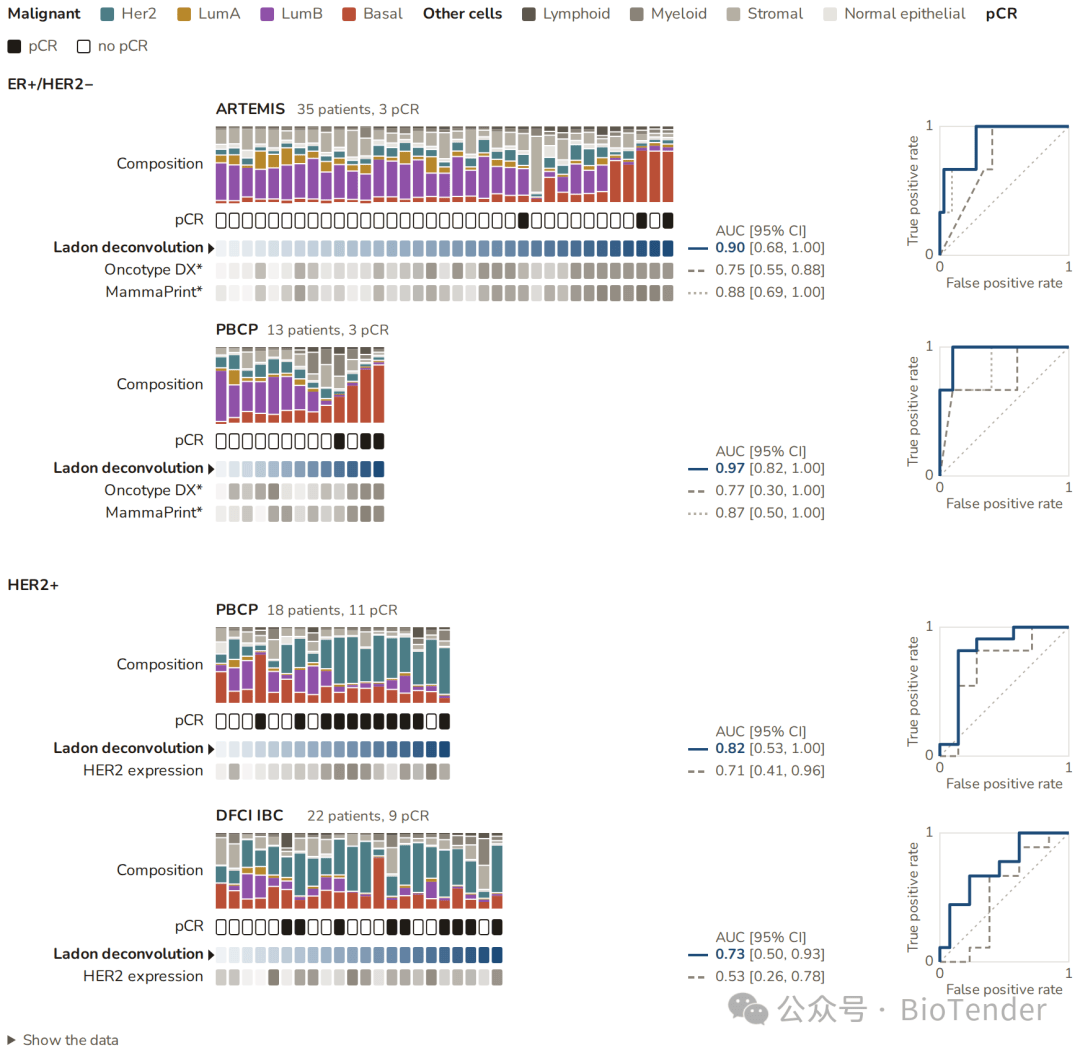
图说 / 由细胞组成预测乳腺癌新辅助治疗病理完全缓解的外部队列评估;商业检测对照为基因表达替代评分
让预训练进步连接到患者任务
团队为此构建了 ClinBench,汇总生存、治疗反应和患者及肿瘤特征等 142 项任务,包括 85 项队列内任务与 57 项跨队列生存任务。报告显示,预训练重建损失越低,综合任务表现总体越好。预训练能力与患者级预测表现的联系,是团队继续扩大模型的依据。
Blank Bio 接下来计划增加模型规模、延长训练,并扩展训练数据。目前官方通过联系合作的方式,邀请研究者将 Ladon 用于自己的队列。从识别预后差异,到辅助寻找治疗获益人群,团队希望将这些能力用于临床开发中的患者分层与试验设计。
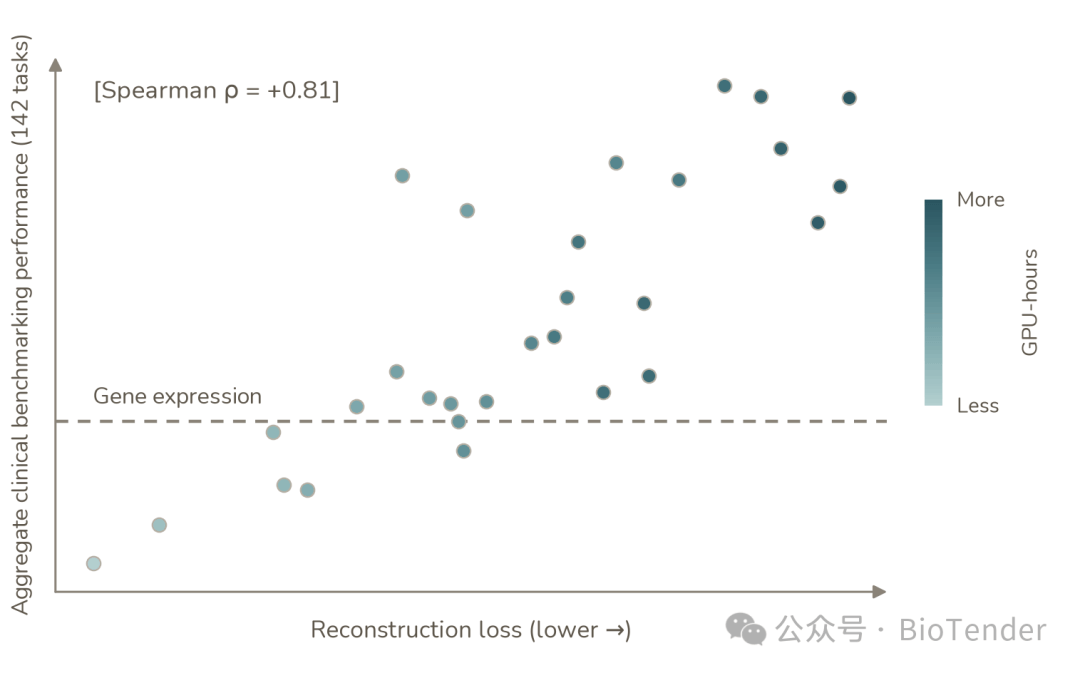
图说 / 预训练重建损失与 ClinBench 综合预测表现的关系