

当业界还在惊叹,思特威刚进军手机消费级赛道就能前后谈下华为和小米两大客户时,一盘面向物理AI的全栈大棋却已在这份瞩目成绩的背后徐徐展开。

恰在此前,思特威还与奥比中光完成了具身智能领域的二次深度合作,而这又只是思特威在AI领域的部分触角延伸。随着其全资子公司威云创达浮出水面,大家才初步看清楚了思特威是如何将AI算力落地物理世界的。
威云创达官方网站上线后,同步带来了两款面向物理AI场景的核心硬件产品:即威云 1000PRO AI 训推一体机,以及威云 Station 物理AI智能体工作站。

而在这两款核心产品的背后,则是一整套威云创达自主研发的异构 AI-ASIC 集群互联技术解决方案:
整套技术基于创新的 WAAG™(威云 AI-ASIC Grid)架构打造,把算力、存力与运力高密度集成在单台服务器之内,再通过高速光互连实现多集群的算力协同与低延迟互联,搭配KV Cache动态卸载技术有效降低存储负载,专为全参数大模型提供高效推理与本地化部署,全面释放极致性能。
至此,再结合思特威的全栈配套布局,便可实现以下具体实际使用场景的完整业务闭环:
从最前端的思特威CIS芯片完成物理世界的视觉感知采集,到飞凌微端侧 AI SoC 就地完成实时数据处理——过滤无效数据从而大幅降低后续链路的传输压力,再通过HOC高速光互连通道实现海量数据的低延迟高速互通,最后由威云创达的异构ASIC集群硬件承接集群训推与智能体运行。

如此四个环节环环相扣, 便能避免多余的算力损耗,从而让物理世界的感知数据能以最高效率流转到应用端。
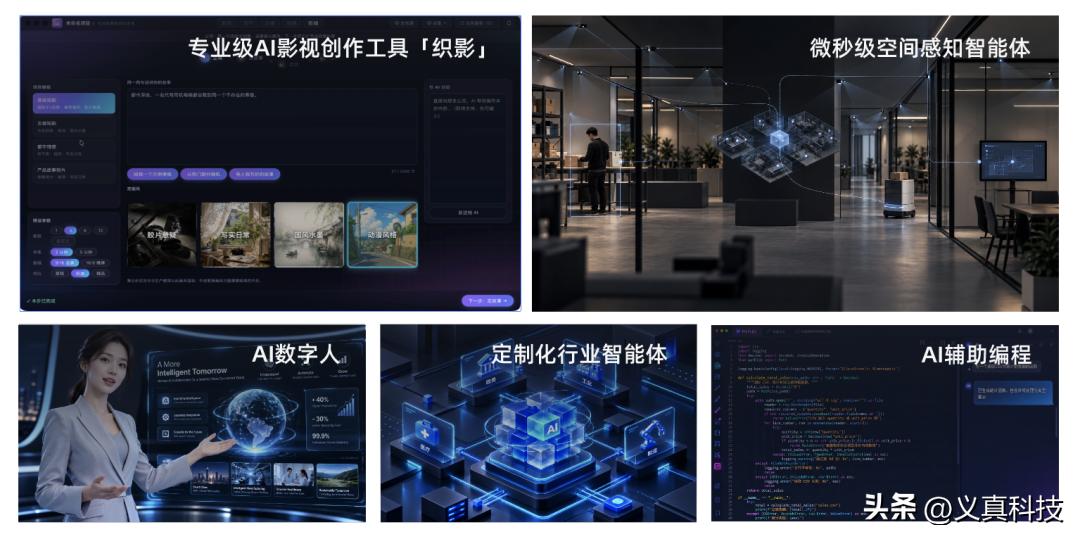
更难能可贵的是,作为面向物理AI、具身智能场景的异构集群训推硬件与行业方案载体,威云创达不仅推出了全套硬件解决方案,还将落地场景精准覆盖了五大核心方向:
1,AI影视创作——可以支撑超高清素材的实时渲染与AI生成内容的本地高效处理,不用再把大文件传到远端算力中心,大幅降低影视后期的时间与算力成本;
2,空间感知智能体——全链路闭环的技术体系可以让机器人、智能终端的环境感知数据就地完成运算,响应速度大幅提升,不用再受限于端云传输的延迟瓶颈;
3,AI数字人——低延迟的集群训推能力可以保障数字人实时交互的流畅度,为虚拟直播、智能客服等场景带来更自然的交互体验;
4,AI辅助编程——本地化部署的训推环境既可以保障企业核心代码数据的安全合规,也能为开发者提供低门槛的高效算力支撑;
5,定制化行业智能体——这套硬件还可以灵活调整算力配比,适配工业、安防、智能制造等不同场景的差异化算力需求。
可见,从一颗CIS感知芯片出发,一步步补齐端侧处理、高速互连、集群训推的关键环节,思特威走的并不是跟风堆算力之捷径,而是扎根物理AI真实场景的长期路线。
另外,当越来越多的AI应用开始从云端走向真实物理世界,这套打通了从感知到训推的全链路底座,或许会成为很多行业落地物理AI的最优解。
而思特威也借由这盘“物理AI大棋”,刷新了大家对其的认知:这已经不是传统印象中的国产CIS大厂了,而是一家完成了从感知采集到端侧处理、高速互连再到集群训推的全链路AI科技企业。


